جمع البيانات من موقع يعترضك فيه اختبار CAPTCHA ليس مسألة حيلة ذكية، بل مسألة ترتيب: اقرأ الصفحة، ميّز نوع الاختبار من الوسم الذي يتركه في HTML، أرسل مفتاح الموقع إلى CaptchaAI، ثم أعد إرسال الرمز الناتج مع الطلب نفسه قبل أن تنتهي صلاحيته. كل ما عدا ذلك — الخادم الوسيط، المهل، إعادة المحاولة — تفاصيل تشغيلية تُبنى فوق هذه الخطوات الأربع.
الدليل مكتوب لمهندس يشغّل سكربت أتمتة على بيانات يملكها أو مصرّح له بالوصول إليها. ستجد فيه تمييز نوع الاختبار، وثلاث إستراتيجيات بكود Python جاهز، وحساب الـ threads قبل اختيار الخطة، وجدول أخطاء يختصر ساعات تصحيح.
متى يكون العمل على المواقع المحمية مبرّراً
الحالات المتكررة في السوق العربي متشابهة إلى حد بعيد:
- فريق تجارة إلكترونية في الرياض يراقب أسعار منتجاته على سوق شريك قبل موسم الجمعة البيضاء، وصفحات السوق محمية بـ Cloudflare Turnstile.
- شركة شحن في القاهرة تسحب حالات الشحنات من بوابة الناقل التي تملك عليها حساباً تعاقدياً، فتظهر لها صفحة اعتراض بعد عدد معيّن من الطلبات.
- فريق QA في دبي يشغّل اختباراً ليلياً على بوابة الدفع الخاصة بشركته، فيتوقف خط الاختبار عند نموذج reCAPTCHA v2 في كل مرة.
القاسم المشترك: الوصول مصرّح به، والهدف موثوقية سير العمل. إن كانت البيانات خلف تسجيل دخول لا تملكه، أو تمنع شروط الاستخدام سحبها، فالحل هو واجهة رسمية أو تصدير متفق عليه — لا سكربت أذكى.
اقرأ الصفحة المحمية بـ CAPTCHA وميّز نوع الاختبار
كل نوع يترك أثراً واضحاً في HTML الصفحة، فلا داعي للتخمين: ابحث عن class="g-recaptcha" وسمة data-sitekey لـ reCAPTCHA، وعن class="cf-turnstile" لـ Cloudflare Turnstile، وعن صفحة اعتراض كاملة تحمل شعار Cloudflare بدل المحتوى المتوقع. اجعل هذا الفحص أول خطوة في السكربت وسجّل نتيجته؛ فمعرفة أن 12% فقط من الصفحات تعرض اختباراً تغيّر تقديرك للتكلفة بالكامل.
| نوع الاختبار | الحالة في CaptchaAI | قيمة method |
|---|---|---|
| reCAPTCHA v2 | ✅ مدعوم | method=userrecaptcha |
| reCAPTCHA v3 | ✅ مدعوم | method=userrecaptcha&version=v3 |
| Cloudflare Turnstile | ✅ مدعوم | method=turnstile |
| Cloudflare Challenge | ✅ مدعوم | method=cloudflare_challenge |
| GeeTest v3 | ✅ مدعوم | method=geetest |
| صورة / OCR | ✅ مدعوم | method=post |
| CaptchaFox | ✅ بيتا | method=captchafox |
| hCaptcha | ❌ غير مدعوم | — |
| FunCaptcha | ❌ غير مدعوم | — |
| GeeTest v4 | ❌ قريباً | — |
الاختبارات التي تُحقن بعد تنفيذ JavaScript لن تظهر في HTML الأولي الذي يعيده طلب requests. في هذه الحالة شغّل الصفحة داخل Selenium أو Puppeteer أو Playwright، واستخرج data-sitekey بعد اكتمال العرض، ثم أرسله إلى CaptchaAI كالمعتاد — التفاصيل الكاملة في دليل التعامل مع CAPTCHA في Selenium.
الإستراتيجية 1: اكتشف الاختبار وحُلّه عند ظهوره فقط
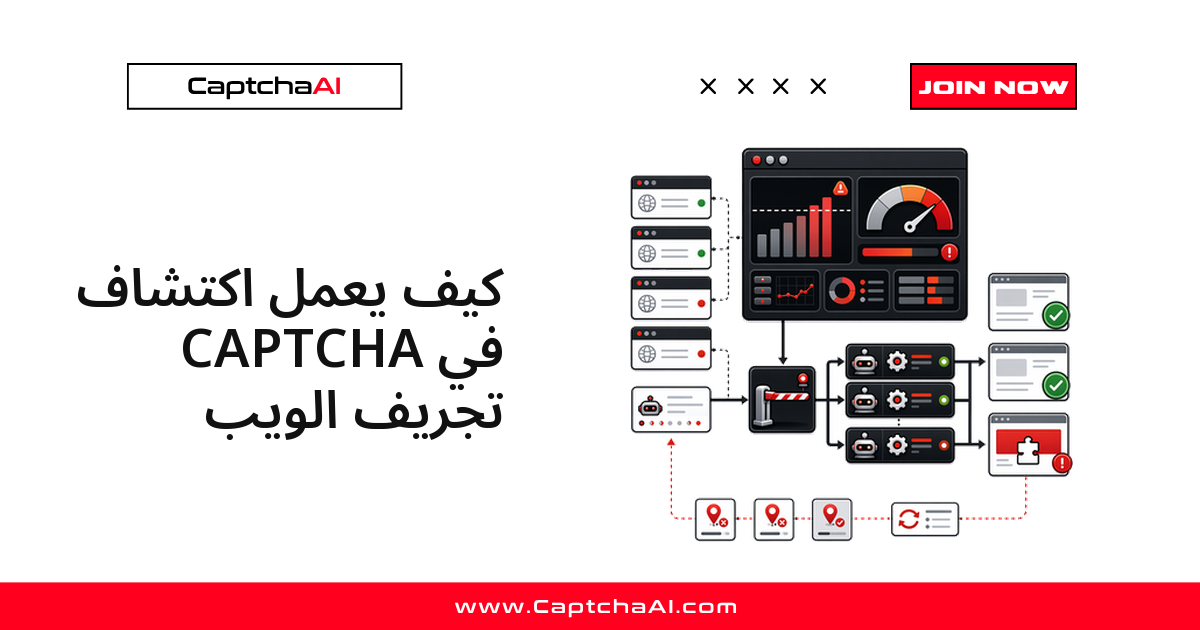
أفضل نمط تشغيلي هو الأقل استهلاكاً: اطلب الصفحة كما يطلبها متصفح عادي، وافحص الاستجابة، ولا ترسل شيئاً إلى CaptchaAI إلا إذا ظهر اختبار فعلاً. بذلك يبقى استهلاك الـ threads متناسباً مع الاعتراضات الحقيقية لا مع حجم الزحف:
import requests
import time
from bs4 import BeautifulSoup

API_KEY = "YOUR_API_KEY"

class ProtectedScraper:
    def __init__(self):
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        })

    def scrape(self, url):
        resp = self.session.get(url)

        # Check for CAPTCHA
        if self._has_captcha(resp.text):
            resp = self._handle_captcha(resp.text, url)

        return resp.text

    def _has_captcha(self, html):
        indicators = ["g-recaptcha", "cf-turnstile", "h-captcha", "captcha"]
        return any(ind in html.lower() for ind in indicators)

    def _handle_captcha(self, html, url):
        soup = BeautifulSoup(html, "html.parser")

        # reCAPTCHA v2
        rc = soup.find("div", class_="g-recaptcha")
        if rc:
            token = self._solve_recaptcha(rc["data-sitekey"], url)
            return self.session.post(url, data={"g-recaptcha-response": token})

        # Cloudflare Turnstile
        ts = soup.find("div", class_="cf-turnstile")
        if ts:
            token = self._solve_turnstile(ts["data-sitekey"], url)
            return self.session.post(url, data={"cf-turnstile-response": token})

        raise Exception("Unknown CAPTCHA type")

    def _solve_recaptcha(self, site_key, page_url):
        resp = requests.get("https://ocr.captchaai.com/in.php", params={
            "key": API_KEY, "method": "userrecaptcha",
            "googlekey": site_key, "pageurl": page_url
        })
        return self._poll(resp.text.split("|")[1])

    def _solve_turnstile(self, site_key, page_url):
        resp = requests.get("https://ocr.captchaai.com/in.php", params={
            "key": API_KEY, "method": "turnstile",
            "sitekey": site_key, "pageurl": page_url
        })
        return self._poll(resp.text.split("|")[1])

    def _poll(self, task_id):
        for _ in range(60):
            time.sleep(5)
            result = requests.get("https://ocr.captchaai.com/res.php", params={
                "key": API_KEY, "action": "get", "id": task_id
            })
            if result.text == "CAPCHA_NOT_READY": continue
            if result.text.startswith("OK|"): return result.text.split("|")[1]
            raise Exception(result.text)
        raise TimeoutError()

# Usage
scraper = ProtectedScraper()
html = scraper.scrape("https://example.com/data")
لاحظ ثلاث نقاط: الجلسة Session واحدة لكل تشغيل حتى تبقى ملفات تعريف الارتباط متسقة، والفحص يعتمد على وسوم الصفحة لا على نص رسالة الخطأ، والاستطلاع الدوري للنتيجة يتم كل خمس ثوانٍ. اضبط User-Agent مرة واحدة والتزم به؛ تغييره في منتصف الجلسة من أكثر أسباب إبطال نتيجة صحيحة.
الإستراتيجية 2: حُلّ الاختبار قبل تحميل الصفحة
بعض الصفحات تعرض الاختبار دون استثناء — نموذج استعلام عن شحنة مثلاً. هنا لا معنى لطلب الصفحة أولاً: أرسل مفتاح الموقع المعروف مسبقاً إلى CaptchaAI، وانتظر الرمز، ثم أرسل الطلب النهائي مع الرمز ضمن بيانات النموذج. توفّر بذلك دورة طلب كاملة لكل صفحة:
def scrape_known_captcha_page(url, site_key):
    # Solve before even loading the page
    token = solve_recaptcha(site_key, url)

    # Submit directly with token
    resp = requests.post(url, data={
        "g-recaptcha-response": token,
        "query": "search term"
    })
    return resp.text
شرط نجاح هذا النمط أن يكون sitekey ثابتاً في الصفحة. إن كان الموقع يولّد مفتاحاً لكل جلسة، ارجع إلى الإستراتيجية الأولى — وإلا ستدفع ثمن حلول لا تُقبل.
الإستراتيجية 3: المواقع خلف Cloudflare وملف cf_clearance
عندما يحجب Cloudflare الصفحة بالكامل بدل عرض عنصر تحقق داخلها، فأنت أمام Cloudflare Challenge لا Turnstile. المطلوب هنا ليس رمزاً تضعه في نموذج، بل ملف تعريف الارتباط cf_clearance مقروناً بـ User-Agent الذي صدر معه، والخادم الوسيط نفسه في كل الطلبات اللاحقة:
def get_cloudflare_clearance(url, proxy):
    resp = requests.get("https://ocr.captchaai.com/in.php", params={
        "key": API_KEY,
        "method": "cloudflare_challenge",
        "pageurl": url,
        "proxy": proxy,
        "proxytype": "HTTP"
    })
    task_id = resp.text.split("|")[1]

    for _ in range(60):
        time.sleep(5)
        result = requests.get("https://ocr.captchaai.com/res.php", params={
            "key": API_KEY, "action": "get", "id": task_id
        })
        if result.text == "CAPCHA_NOT_READY": continue
        if "cf_clearance" in result.text:
            # Parse cf_clearance and user_agent from response
            return result.text
    raise TimeoutError()
Cloudflare Challenge يُحل عادة في أقل من 15 ثانية وTurnstile في أقل من 10 ثوانٍ؛ اضبط المهل على هذا الأساس.
شغّل صفحات متعددة دون إغراق الموقع
عند الانتقال إلى مئات الصفحات تتحول المشكلة من «كيف أحل الاختبار» إلى «كيف لا أستدعي المزيد منه». أضف فاصلاً عشوائياً بين الطلبات، وسجّل كل صفحة فاشلة بدل إيقاف التشغيل كاملاً:
def scrape_multiple_pages(base_url, site_key, pages):
    scraper = ProtectedScraper()
    results = []

    for page in pages:
        url = f"{base_url}?page={page}"
        try:
            html = scraper.scrape(url)
            soup = BeautifulSoup(html, "html.parser")
            items = soup.find_all("div", class_="item")
            results.extend([item.text.strip() for item in items])
            print(f"Page {page}: {len(items)} items")
        except Exception as e:
            print(f"Page {page} failed: {e}")

        time.sleep(random.uniform(2, 5))

    return results
احسب عدد الـ threads قبل أن تحسب الفاتورة
فوترة CaptchaAI قائمة على عدد الـ threads المتزامنة لا على عدد الحلول: كل خطة تمنحك عدداً محدداً من الـ threads وحلولاً غير محدودة داخل كل منها. الـ thread الواحد اختبار واحد قيد التنفيذ، وبمجرد انتهائه يلتقط التالي.
| الخطة | السعر الشهري | عدد الـ Threads |
|---|---|---|
| BASIC | $15 | 5 |
| STANDARD | $30 | 15 |
| ADVANCE | $90 | 50 |
طبّق ذلك على مثال شركة الشحن في القاهرة: 4,000 صفحة يومياً، ويظهر Turnstile في نحو 12% منها، أي قرابة 480 حلاً — ومع زمن حل أقل من 10 ثوانٍ فذلك أقل من 80 دقيقة معالجة موزعة على اليوم. المتغير الحقيقي هو ذروة التزامن لا الإجمالي اليومي: ضغط التشغيل في نافذة ليلية قصيرة يستهلك threads أكثر بكثير من توزيعه على 12 ساعة. ابدأ من BASIC: $15 شهرياً و5 threads، وراقب طول قائمة الانتظار قبل الترقية. الأسعار بالدولار الأمريكي ومرجعها صفحة الأسعار على captchaai.com.
أخطاء متكررة وكيف تصلحها
| العَرَض | التشخيص والإصلاح |
|---|---|
| الاختبار يظهر في كل صفحة تقريباً | معدل الطلبات مرتفع أو عنوان IP واحد — وزّع الحركة وأضف فاصلاً زمنياً |
| الرمز مرفوض رغم نجاح الحل | انتهت صلاحيته؛ أرسله خلال 120 ثانية من استلامه |
| Cloudflare يحجبك رغم وجود cf_clearance | اختلف الخادم الوسيط أو User-Agent بعد التصريح — وحّدهما |
| الاستجابة صفحة مختلفة عن المتوقعة | تحقق من إعادة التوجيه وملفات تعريف الارتباط بعد الحل |
CAPCHA_NOT_READY لا تنتهي |
المهلة قصيرة أو sitekey خاطئ — أعد استخراجه من الصفحة المعروضة |
الأسئلة الشائعة
هل يجوز لي جمع بيانات من موقع محمي بـ CAPTCHA؟
المعيار تعاقدي قبل أن يكون تقنياً: راجع شروط الاستخدام وملف robots.txt، وتأكد أن البيانات عامة أو أن لديك تصريحاً بالوصول. والبيانات الشخصية تخضع لأنظمة حماية البيانات في السعودية والإمارات ومصر، وتحتاج أساساً قانونياً مستقلاً.
كم عدد الـ threads الذي أحتاجه؟
احسبه من الذروة لا من الإجمالي: اضرب عدد الاختبارات في الساعة الأكثر ازدحاماً في متوسط زمن الحل، ثم اقسم على 3,600، وأضف هامشاً لإعادة المحاولة. معظم مشاريع مراقبة الأسعار تبدأ مرتاحة بين 5 و15 thread.
لماذا يُرفض الرمز رغم أن الحل عاد ناجحاً؟
ثلاثة أسباب بالترتيب: تأخر الإرسال حتى انتهت الصلاحية، أو اختلاف عنوان IP بين لحظة الحل ولحظة الإرسال، أو pageurl لا يطابق الصفحة التي يُقدَّم فيها النموذج.
ماذا لو كان الموقع يستخدم hCaptcha أو FunCaptcha؟
لا يغطي CaptchaAI هذين النوعين حالياً، وGeeTest v4 معلن كـ«قريباً» ولم يُتَح بعد. إن كان النوع غير مدعوم فالمسار العملي هو واجهة رسمية أو تصدير بيانات متفق عليه مع مالك الموقع.
هل أحتاج إلى وكيل سكني لكل طلب؟
لا في الغالب. ابدأ بعناوين مركز بيانات وقِس معدل ظهور الاختبار، ثم انقل الصفحات الحساسة وحدها إلى وكيل سكني. والخلط بين نوعي الوكلاء في الجلسة الواحدة سبب شائع لسقوط التصريح.